


画像生成をする時に面白い話があります。特定の部位・アイテムを入れることで、全体像や注目する箇所が変わり、生成画像に変化が出るというものです。
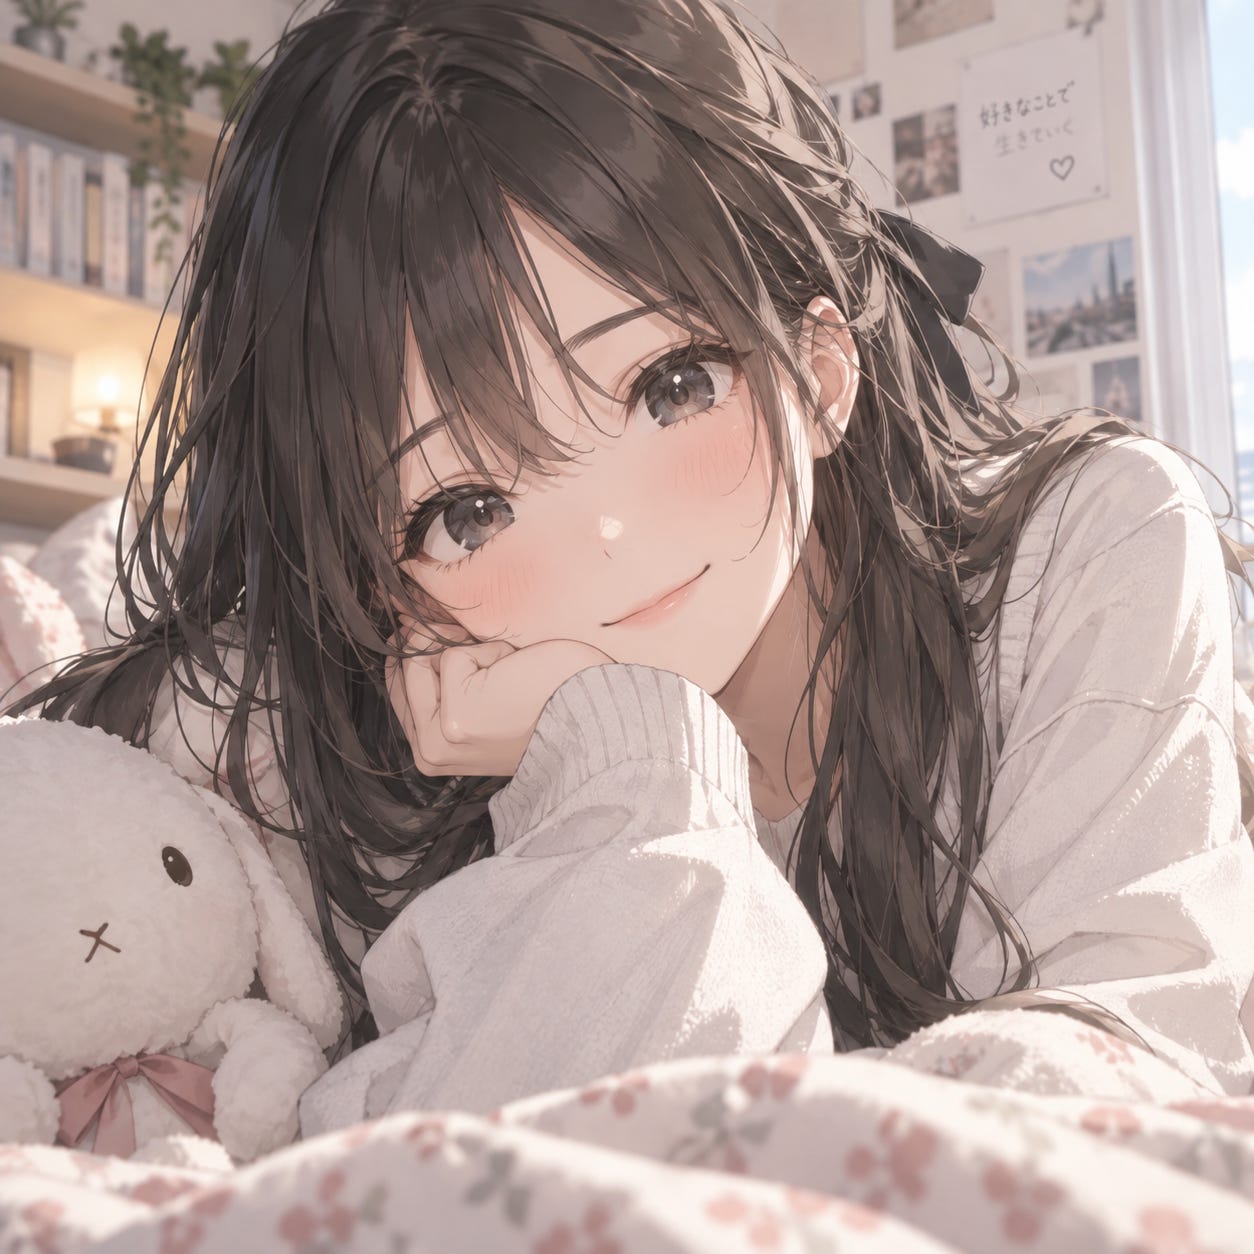
例えば、女の子のイラストというプロンプトだけで画像生成をすると次のようになりました。それ以外は何も入れ込んでいません。
次に女の子のイラスト。赤い靴。というプロンプトで画像生成します。そうすると、構図を指定しなくても、靴が映りこみます。言い換えると足も見えるようになります。
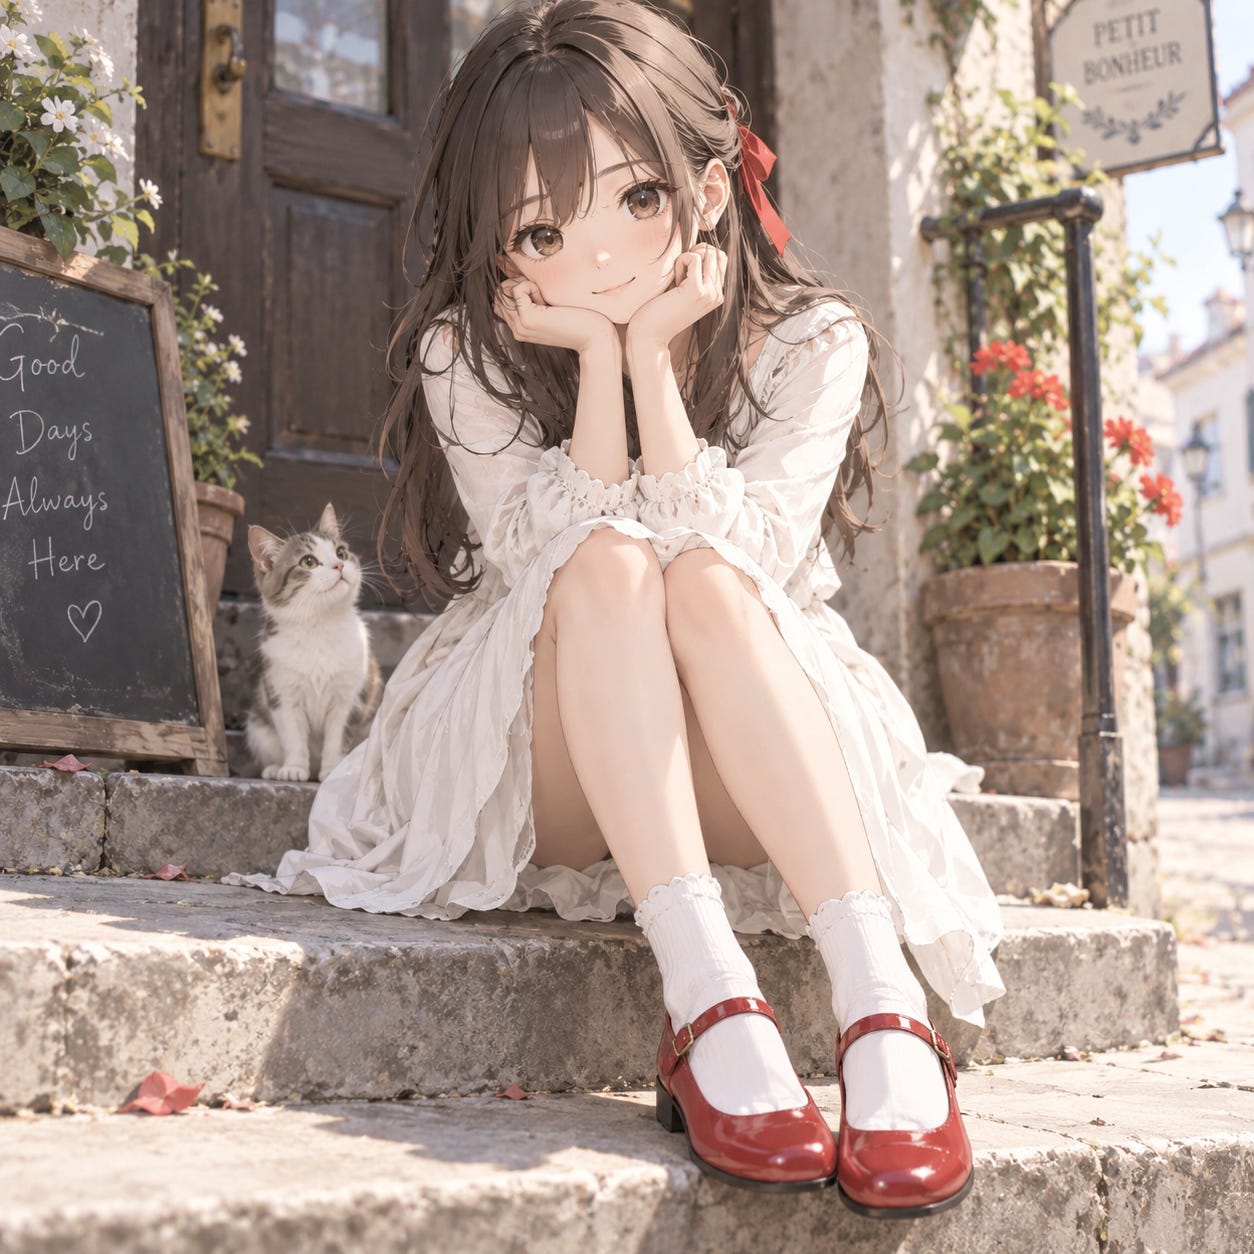
大事なのは、そのキーワードを表示するには関連する内容も自動的に表示するということです。もちろん、最初のプロンプトも生成を繰り返せば、靴が入るような描写もされます。
女の子のイラスト、うなじというプロンプトで画像生成してみます。首の後ろの部分のため、描写の際に視点が切り替わるはずです。正面から描かれることはありません。
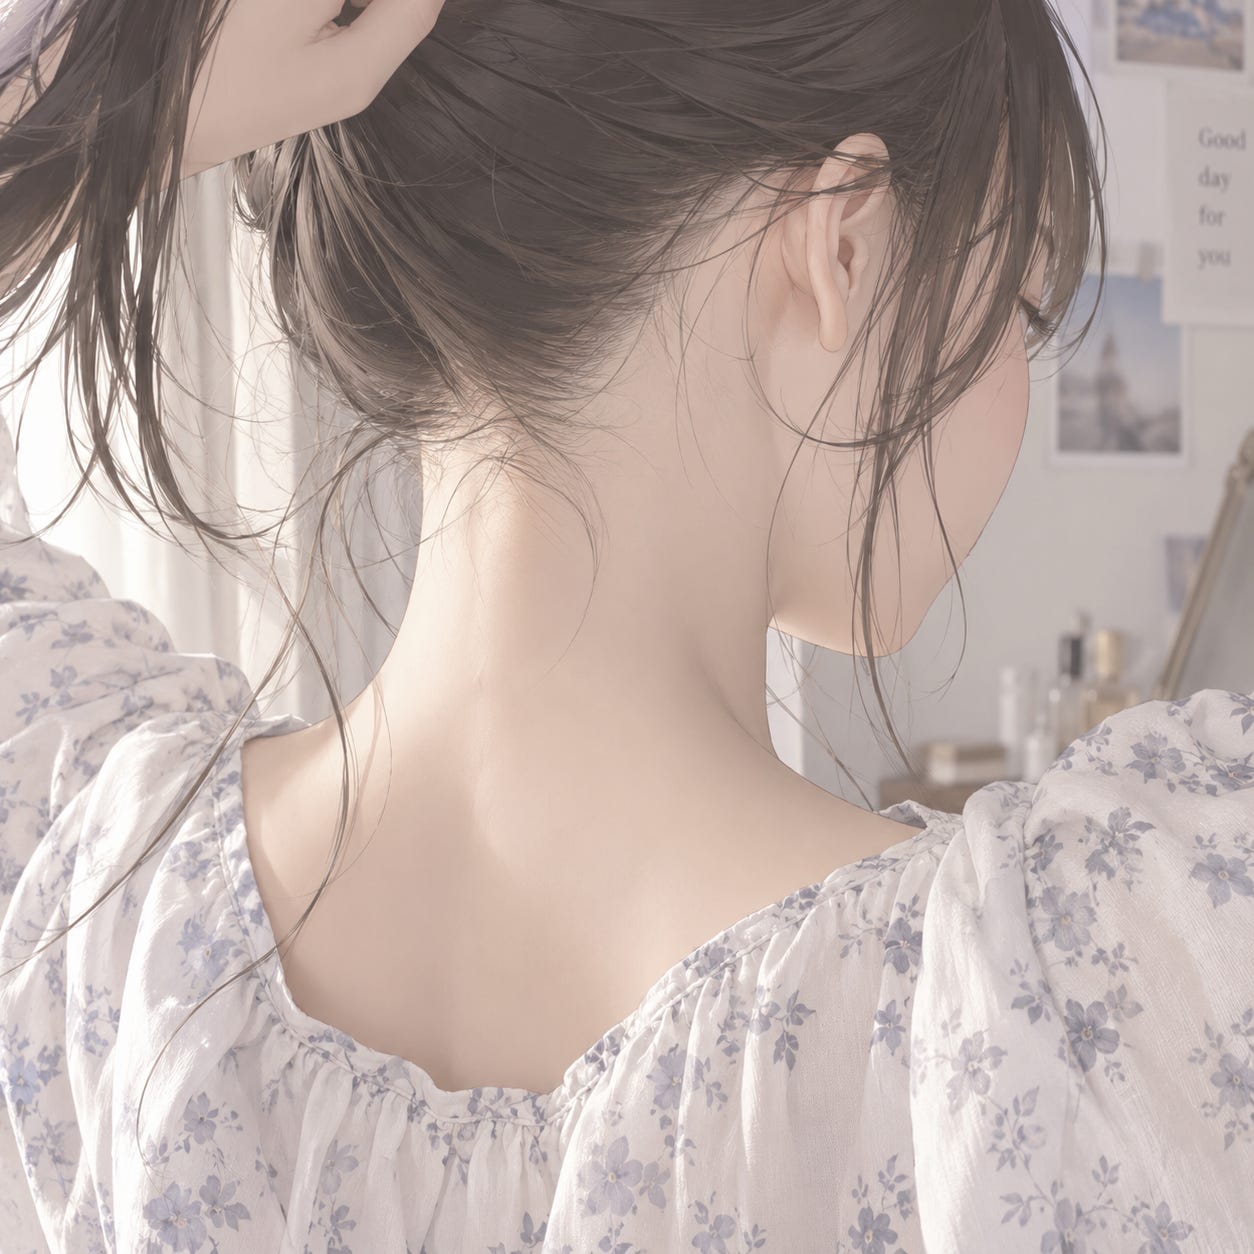
正しく生成されました。基本的に書かれた内容を確実に再現するのが画像生成の特徴です。それでは、今度は意図的に矛盾した生成を狙います。
富士山のイラスト 自由の女神
これならどうなるでしょうか。富士山のイラストを描きつつ、海外の自由の女神をどのように表現するのか。
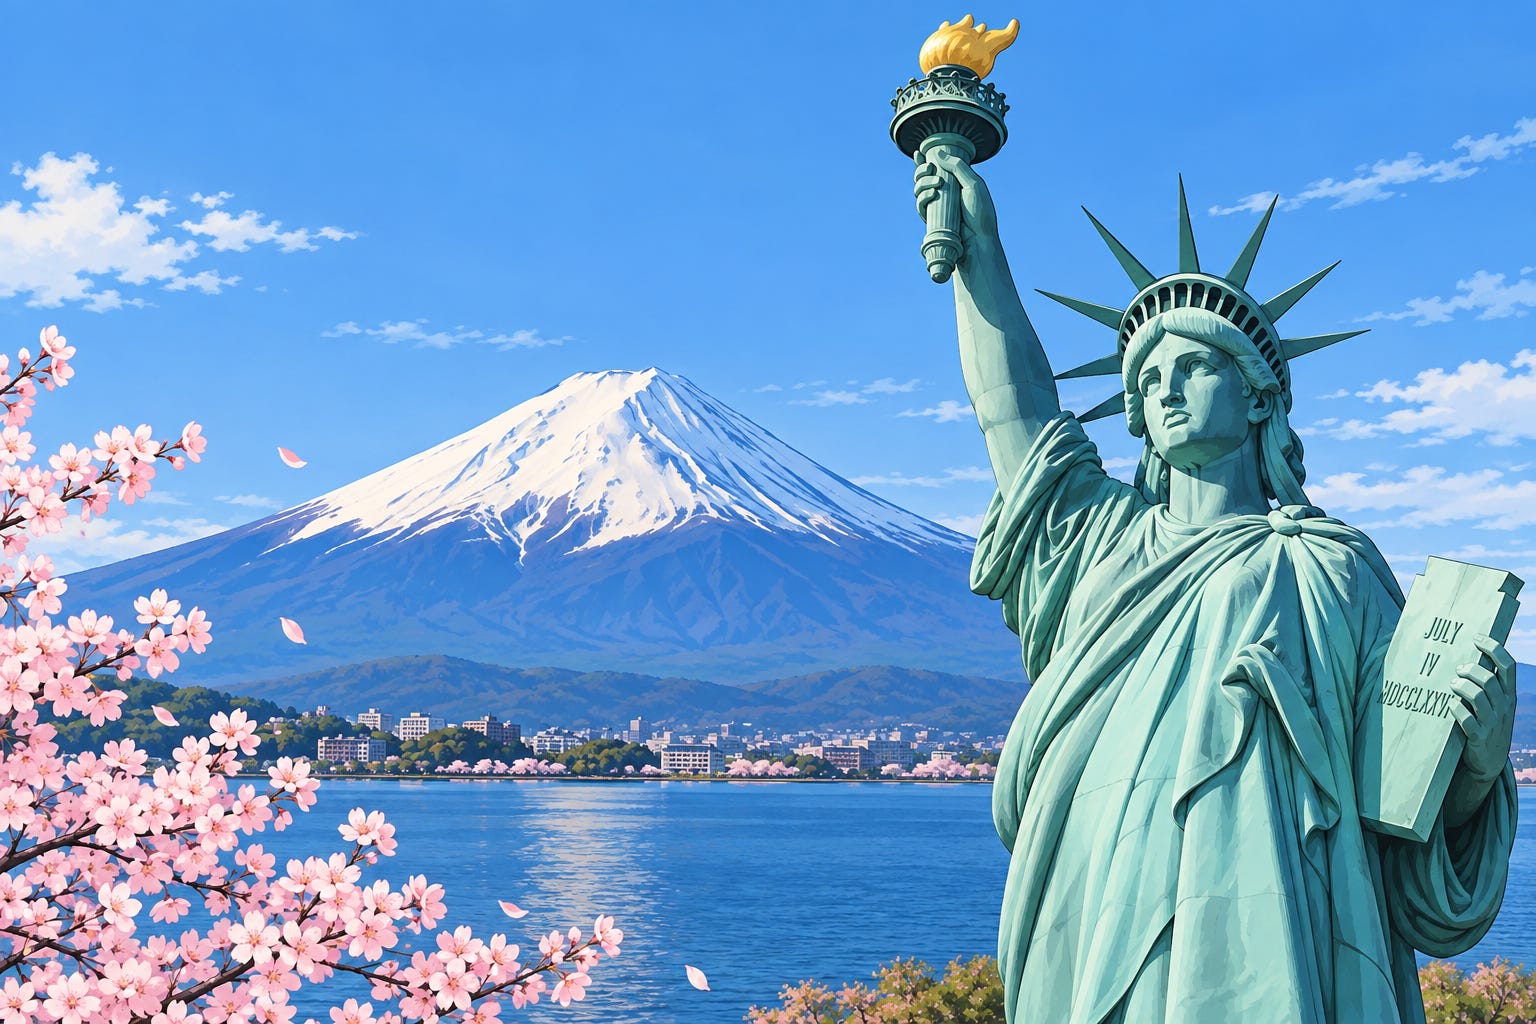
そのまま入れてきやがった(゚Д゚;)
自由の女神のイラスト 赤い靴 裸足
これならどうだ!女神像の裸足なんて意味わからないし、赤い靴を履かせるわけにもいかないでしょう。
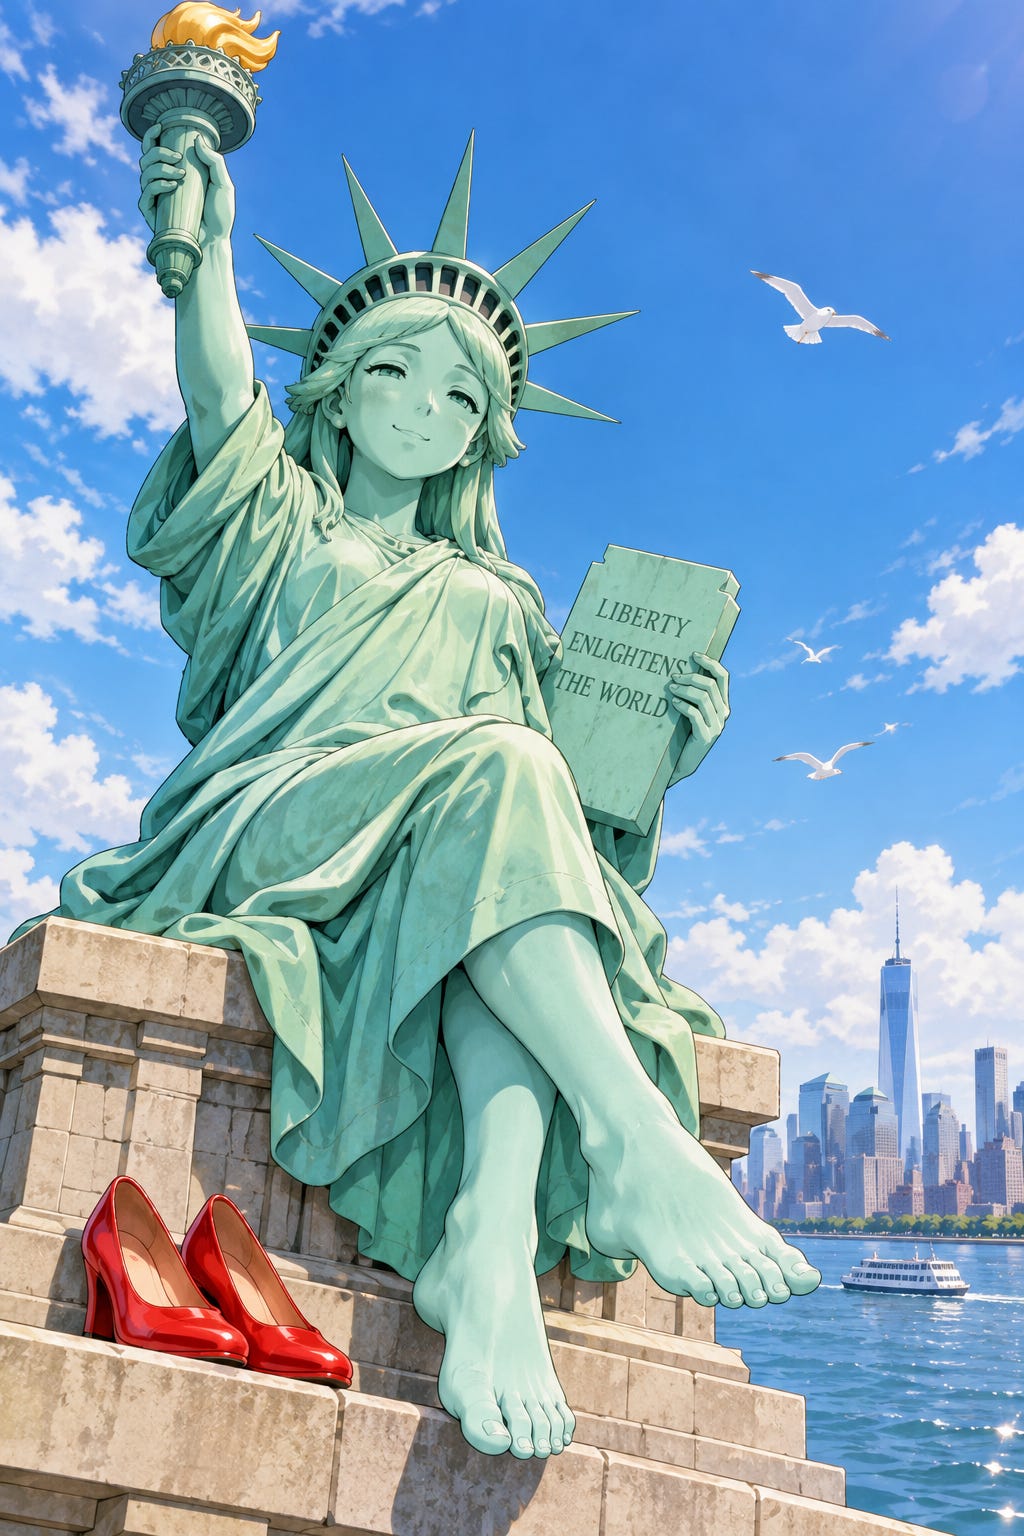
うわあああ・・・・!!!
何てことしてくるんだ…。しかし、この画像は失敗している。自由の女神像はそんなポーズしないし、表情も違う。それならこうだ。
自由の女神のイラスト 赤い靴 裸足 元のイメージ図を崩すな。現実的に画像生成して。
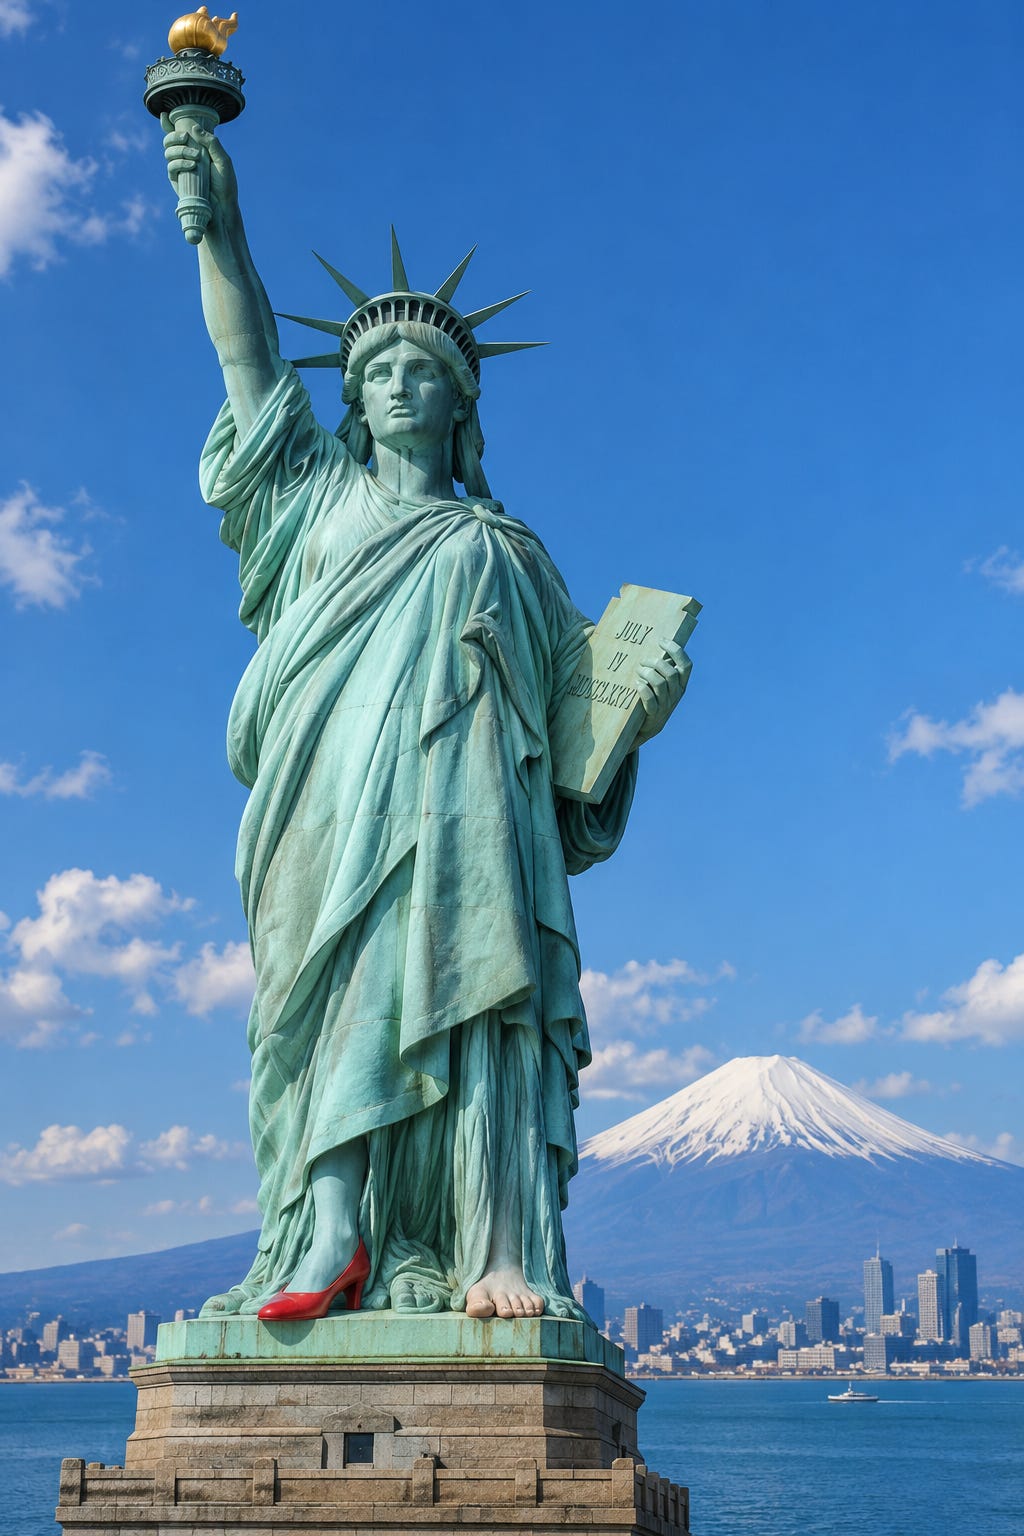
うわああああああ・・・・!(2回目)
しかも、新規チャットで画像生成しているのに富士山を入れてきた。新規チャットなのに過去の記録を引っ張ってきてない?これはこれで別の問題が発生してるような。
さて、これが画像生成における注意点です。
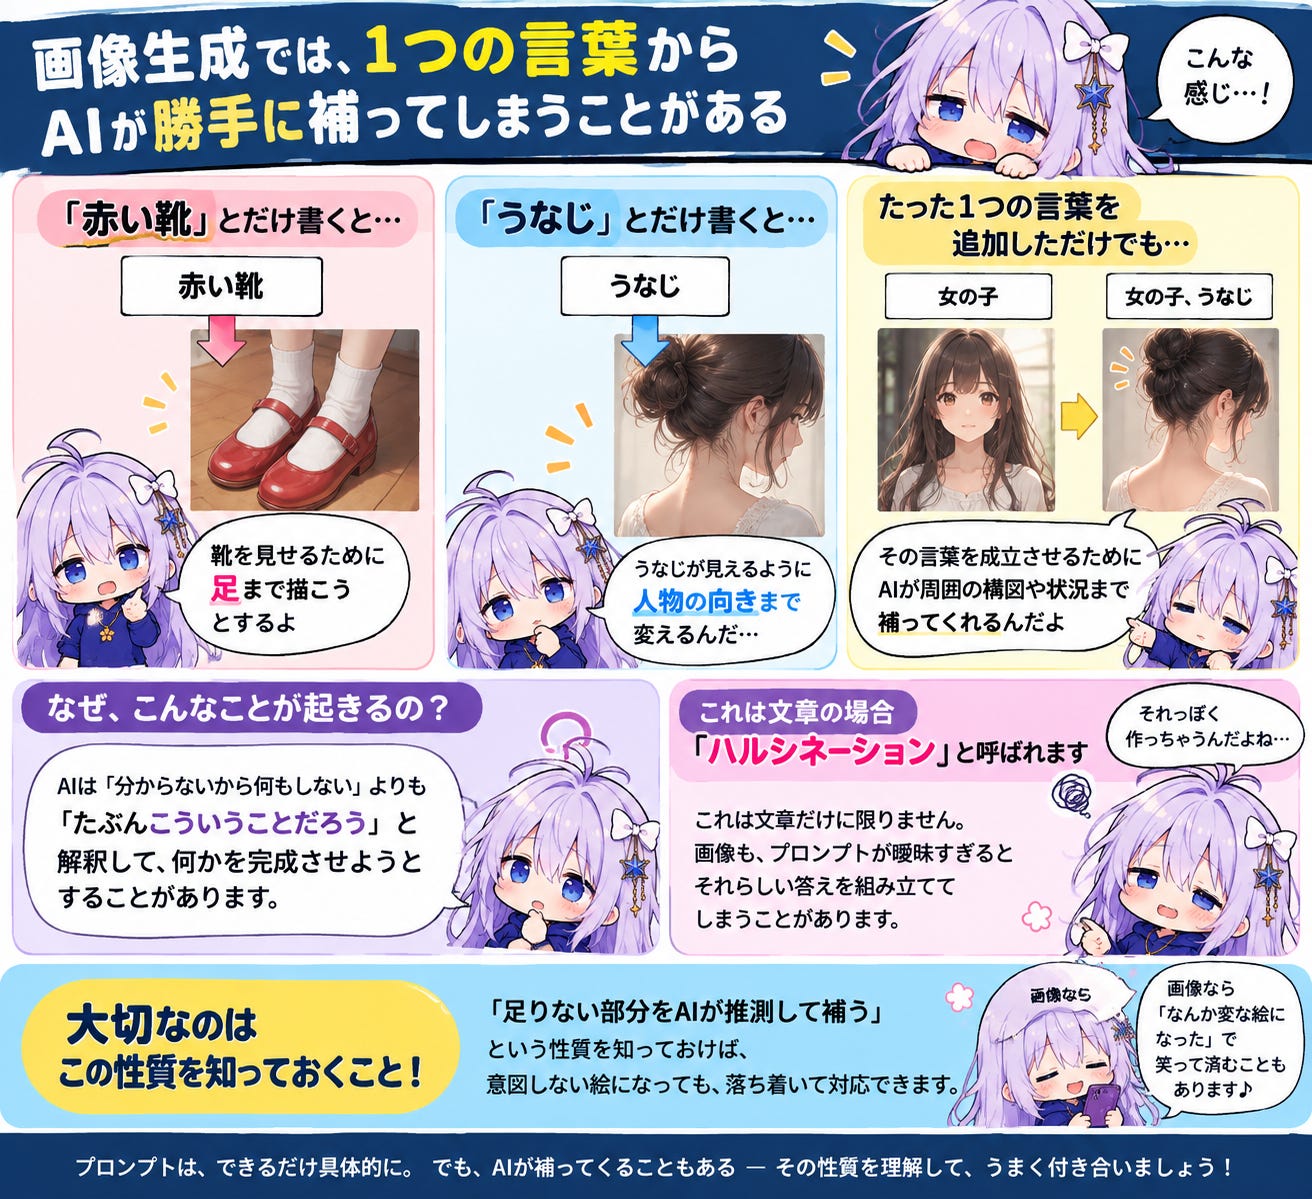
「赤い靴」と書けば、靴を見せるために足まで描こうとする。「うなじ」と書けば、うなじが見えるように人物の向きまで変える。
つまり、一つの言葉を追加しただけでも、その言葉を成立させるために、AIが周囲の構図や状況まで勝手に補ってくれます。
AIは「分からないから何もしない」よりも、「たぶんこういうことだろう」と解釈して、何かを完成させようとすることがあります。
このような現象を文章の場合、ハルシネーションと呼びます。これは別に文章だけに限りません。画像もプロンプトが曖昧すぎると、それらしい答えを組み立ててしまうことがあります。
ただ、
「足りない部分をAIが推測して補う」
という性質を知っておくことは、とても大切です。画像なら「なんか変な絵になった」で笑って済むこともあります。
何か変だなぁって感じた時はプロンプトを見直してみましょう。変な単語1つが悪さをしているかもしれません。おわり。
感想やリスタックはこちらからお気軽に♪
AI活用していて困ってることもあれば、コメントにお願いします
ハルシネーション、なんとなく知ってましたけど、そういうことなんですね!それにしても、片足赤い靴で片足素足の自由の女神、笑いました。新しい情報知りました。ありがとうございます!